Knowledge Base: las preguntas que tu esquema no hizo
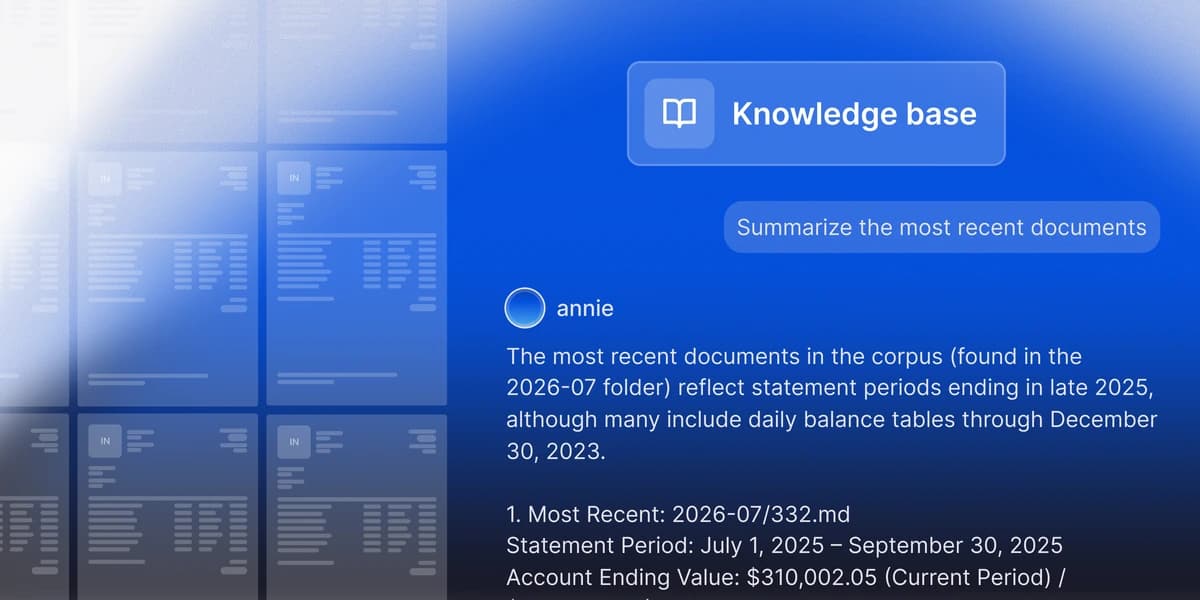
La salida estructurada responde a las preguntas que sabías hacer cuando diseñaste el esquema. Cada flujo de anyformat incluye ahora una base de conocimiento que responde a las que no hiciste, y cada respuesta cita la página y la región de la que salió.
Un esquema es una lista de preguntas. Contraparte, fecha de entrada en vigor, importe del contrato, condiciones de pago: cada campo es una pregunta que sabías hacer cuando diseñaste el flujo, y la extracción la responde en cada documento, a volumen, con una puntuación de confianza al lado. Ese es el trabajo, y es la mayor parte del valor.
Pero un esquema se escribe antes de que lleguen los documentos, y los documentos no lo leen. Tres meses después, alguien de finanzas necesita saber cuáles de los contratos procesados este trimestre se renuevan antes de marzo, y qué preaviso exige cada uno. Nadie puso la cláusula de renovación en el esquema, porque nadie pensaba en renovaciones cuando el esquema iba de importes. La respuesta está en los documentos. El flujo los ha procesado todos. Y las únicas formas de conseguirla son abrir los PDF uno a uno, o escribir un esquema nuevo, relanzar la extracción y esperar.
La salida estructurada responde a las preguntas que sabías hacer. Las que no hiciste no son la excepción. Son la mayoría de las preguntas que recibe un documento después de haber sido procesado. Desde hoy, cada flujo de anyformat responde también a esas, con la misma evidencia detrás de cada respuesta que hay detrás de cada campo extraído.
Lo que sale hoy
Cada flujo de anyformat puede incluir ahora una base de conocimiento. Añades el nodo Knowledge Base al lienzo, aguas abajo de Parse, Extract o Validate. No tiene opciones: su presencia es el interruptor. Después de cada ejecución, el último parseo de cada documento del flujo se compila en el corpus, y el corpus se acumula entre ejecuciones y versiones del flujo. Después le haces preguntas, desde la pestaña Knowledge Base en Studio o desde el endpoint /ask, y cada respuesta vuelve con citas: el fichero, la página y el recuadro de la región de la que se leyó la respuesta.
Pongamos un flujo de contratos de proveedores. Parse lee cada contrato en páginas y bloques. Extract saca la contraparte, la fecha de entrada en vigor y el importe. Validate comprueba el importe contra el pedido de compra. El nodo Knowledge Base está al final y compila todo lo que Parse ha producido. Ahora hazle la pregunta del párrafo de arriba. Esta es la petición, y esta es la respuesta tal y como aparece en la referencia de la API (el ejemplo de la referencia deja una sola cita por brevedad):
curl -X POST 'https://api.anyformat.ai/v3/workflows/{workflow_id}/knowledge/ask' \
  -H 'Authorization: Bearer YOUR_API_KEY' \
  -H 'Content-Type: application/json' \
  -d '{"question": "Which contracts renew before March and what notice do they need?"}'
{
"answer": "Two contracts renew before March. Meridian MSA renews 2026-02-01 and needs ninety days' notice to terminate. Aldrete supply agreement renews 2026-02-14 with thirty days' notice.",
"citations": [
{
"path": "2026-07/meridian-msa-2024.md",
"quote": "Either Party may terminate upon ninety (90) days' notice.",
"file_id": "0192f0c1-a2b3-4c5d-8000-abcdef012345",
"block_id": "block-2",
"page": 2,
"bbox": { "x0": 0.08, "y0": 0.31, "x1": 0.92, "y1": 0.36 }
}
],
"path": [
{ "tool": "kb_grep", "args": { "pattern": "renewal" } },
{ "tool": "kb_read", "args": { "path": "2026-07/meridian-msa-2024.md" } }
],
"steps_used": 2,
"thread_id": null
}La cita no es el título de un documento ni el número de un fragmento. Es una frase, en una página, dentro de un rectángulo. El camino muestra cómo se encontró la respuesta: una búsqueda de cláusulas de renovación, una lectura del contrato de Meridian, dos pasos. En Studio, al pulsarla se abre esa página con la región resaltada, de modo que comprobar una respuesta tarda los dos segundos que debería tardar. Las preguntas de seguimiento pasan un identificador de hilo y conservan el contexto de las anteriores.
Por qué no es un vector store
La forma obvia de construir esto es la que todo el mundo ha visto: trocear el texto, generar embeddings de los trozos, guardar los vectores, recuperar los más cercanos y meterlos en un prompt. RAG en su forma habitual. No lo hemos construido así, y cada decisión tiene su razón.
El corpus es el parseo, no una segunda copia del documento. La extracción ya se ejecutó sobre una representación parseada: páginas, bloques, tablas, cada bloque con su posición en la página. La base de conocimiento se compila a partir de esos mismos bloques. No hay una ingesta aparte, ni una segunda pasada de OCR, ni un troceador con su propia opinión sobre dónde termina un párrafo. Una representación significa una verdad. Un campo que Extract sacó del bloque 2 de la página 2, y una respuesta que cita el bloque 2 de la página 2, señalan la misma tinta.
La recuperación navega el documento en lugar de buscar texto parecido. La búsqueda por similitud devuelve los fragmentos que se parecen a la pregunta. Para «qué preaviso» en cuarenta contratos, eso son cuarenta párrafos casi idénticos y ninguna forma fiable de saber cuál pertenece a cuál. El agente de respuesta trabaja como trabaja una persona con un archivador: lista lo que hay, abre los documentos que importan, lee las secciones que importan y para. La respuesta devuelve el camino que ha seguido y el número de pasos que ha usado, como en el ejemplo de arriba, así que la recuperación se puede inspeccionar en lugar de quedar escondida detrás de un umbral de similitud.
Sin vector store en el camino crítico. Nada que volver a vectorizar cuando cambia un modelo. Ningún índice que reconstruir. Ningún segundo almacén que respaldar, proteger y mantener sincronizado con los documentos de los que salió. La compilación es incremental: después de una ejecución, solo se compilan las páginas cuyo contenido es nuevo o ha cambiado, y esas son las únicas páginas que pagas.
Una sola cadena de auditoría. Extracción, validación y /ask citan el mismo parseo: los mismos identificadores de fichero, las mismas páginas, los mismos identificadores de bloque, los mismos recuadros. Cuando un auditor pregunta de dónde ha salido un número, la evidencia tiene la misma forma tanto si el número salió de un esquema como si salió de una pregunta. Esa es la diferencia entre un asistente atornillado a un almacén de documentos y una función del flujo.
Compilado, no indexado. La base de conocimiento no es un índice sobre texto. Es el propio corpus parseado del flujo, hecho consultable. Que sepamos, nadie más entrega esto: una respuesta, un campo extraído y un veredicto de validación que señalan al mismo bloque de la misma página, dentro del mismo flujo. Ese es el nivel de anclaje al que nos referimos cuando decimos citado.
Nivel empresarial por herencia
Como la base de conocimiento es un nodo del flujo, hereda la postura del flujo. Los documentos desde los que responde son los documentos que el flujo ya tiene, bajo la misma organización, el mismo control de acceso y el mismo tratamiento de datos. El corpus está acotado al flujo: una pregunta hecha a un flujo no puede leer los documentos de otro. No hay exportación a un servicio aparte, ni una segunda copia del corpus viviendo en otro sitio con sus propias reglas de retención. Los controles con los que la plataforma consiguió su certificación ISO 27001 lo cubren porque nunca ha salido de la plataforma.
El coste está acotado de la misma manera. Una pregunta se mide por el texto que el agente lee de verdad, y una pregunta que la organización no puede pagar se rechaza antes de ejecutar nada, no se factura después.
Cómo empezar
Añade el nodo Knowledge Base a cualquier flujo, ejecútalo una vez y pregunta. Hasta que termina la primera compilación, /ask devuelve un 409 en lugar de una respuesta parcial. A partir de ahí, las preguntas van por la pestaña Knowledge Base de Studio o por POST /v3/workflows/{workflow_id}/knowledge/ask, con una pregunta en lenguaje natural y un identificador de hilo opcional.
El precio es el modelo por página publicado. Compilar cuesta 2 créditos por página, cobrados solo por el contenido nuevo o modificado, así que Parse más Knowledge Base suma 27 créditos por página. Una pregunta cuesta 8 créditos por cada 10.000 tokens de entrada que lee el agente, lo que significa que una pregunta concreta cuesta menos que una amplia. Navegar y buscar en el corpus desde Studio es gratis.
El corpus también está abierto a los agentes. El servidor MCP de anyformat lo expone mediante ask_knowledge, search_knowledge y read_knowledge, de modo que un asistente de código o un agente tuyo puede construir encima desde hoy. Pronto llegarán más capacidades agénticas sobre la base de conocimiento.
Knowledge Base está disponible hoy en la plataforma de anyformat. La documentación cubre el nodo, la pestaña y el endpoint en detalle.
anyformat es la plataforma de inteligencia documental que convierte documentos no estructurados en datos fiables y estructurados, con seguridad de nivel empresarial, puntuaciones de confianza y trazabilidad completa. Más información en anyformat.ai.