
Modo Flash: PDF de origen digital, sin llamada al modelo
La mayoría de los PDF que procesa un back office nunca pasaron por un escáner. El texto ya está en el fichero. Flash es el modo de Parse que lo lee directamente de la capa de texto, sin ningún modelo por medio, a 7 créditos por página en lugar de 25, y devuelve los mismos bloques, recuadros y confianza que espera el resto de operadores.
Mira lo que llega de verdad a un flujo documental cuando hay volumen y el patrón aparece enseguida. Los escaneos son la minoría. La mayoría de las páginas salieron de una máquina: una factura generada por un sistema de facturación, un extracto exportado desde el portal del banco, un contrato producido a partir de una plantilla en un procesador de textos, un informe impreso directamente a PDF. Nadie las fotografió. El texto está dentro del fichero, carácter a carácter, con las coordenadas de cada palabra.
Y aun así, la práctica por defecto de la industria, la nuestra incluida, ha sido tratar todas las páginas igual: renderizarlas a píxeles y entregar los píxeles a un modelo que los vuelve a convertir en texto. Para un escaneo es la única opción. Para un PDF de origen digital significa pagar a un modelo, y esperarlo, para reconstruir un texto que el fichero ya contiene.
Por qué la capa de texto nunca bastó por sí sola
Si el texto está en el fichero, ¿por qué no leerlo sin más? Quien lo haya intentado conoce la respuesta. Un volcado en bruto de la capa de texto te da los caracteres y nada de la estructura. Dos columnas salen entrelazadas. Una tabla se convierte en una ristra de números sin filas. Encabezados, pies y números de página aterrizan en mitad de los párrafos. El orden de lectura sigue el orden en que el programa que generó el fichero decidió emitir los glifos, que muchas veces no es el orden en que lee una persona. Los caracteres están bien y el documento está mal.
Así que el mercado se conformó con dos respuestas. Pasarlo todo por un modelo de visión, que es preciso y caro. U ofrecer un nivel barato que es o bien un modelo más pequeño o bien texto plano sin diseño, que es más barato y pierde justo la estructura que una extracción posterior necesita. Ninguna de las dos trata la página de origen digital como lo que es: un documento cuyo texto ya se conoce, y cuya estructura es lo único que queda por resolver.
Flash: la capa de texto, más el diseño, menos el modelo
Flash es un nuevo modo del operador Parse. Lee la capa de texto del propio PDF y la ancla al diseño de la página: bloques, orden de lectura, la posición de cada fragmento de texto. No hay llamada a ningún modelo. No se renderizan píxeles, no se ejecuta inferencia, no se consumen tokens.
La salida es la misma que produce Parse en cualquier otro modo. Markdown del documento completo. Bloques con sus recuadros y una puntuación de confianza. Los mismos parse_confidence y layout_confidence que lee el resto de la plataforma. Eso importa más que el precio, porque todo lo que viene después está construido sobre esos bloques. Extract saca campos de ellos y cita la región de la que leyó cada valor. Validate los comprueba. Edit detecta en ellos los campos de un formulario. La Knowledge Base los compila y responde preguntas con una cita a la página. Ninguno de esos operadores sabe ni le importa qué modo produjo los bloques. Pasar un flujo a Flash cambia un ajuste en el nodo Parse y nada más en la tubería.
El coste es de 7 créditos por página, frente a 25 en Standard. Y como no hay ningún modelo por medio, no hay inferencia a la que esperar.
La página escaneada en mitad del lote
La limitación honesta de un parser de capa de texto es la página que no tiene capa de texto. Un contrato de origen digital con una página de firmas escaneada grapada al final. Un PDF de factura donde la página uno se generó y la página dos es un albarán fotografiado. En un lote de diez mil ficheros siempre habrá alguna.
Flash no adivina. Cada página cuya capa de texto no contiene palabras se trata según la política que el flujo fija en scanned_pages, y hay tres. ocr procesa esa página como cualquier otra, por la vía de OCR, de modo que la ejecución termina con el documento entero legible. skip la sirve en blanco y la marca, para tuberías donde una página que falta es aceptable y una sorpresa no lo es. fail detiene la ejecución con un error que nombra los números de página, para tuberías donde una página escaneada significa que ese documento nunca debió entrar en este flujo.
Cuál es la correcta depende del proceso, y por eso es un ajuste y no un valor por defecto que hayamos elegido por ti. Lo importante es que el comportamiento es explícito y el resultado de la ejecución te dice qué ha pasado. Una página escaneada en un flujo con Flash es un hecho que aprendes de la ejecución, no de un campo vacío tres pasos después.
Cuatro modos, un solo contrato de salida
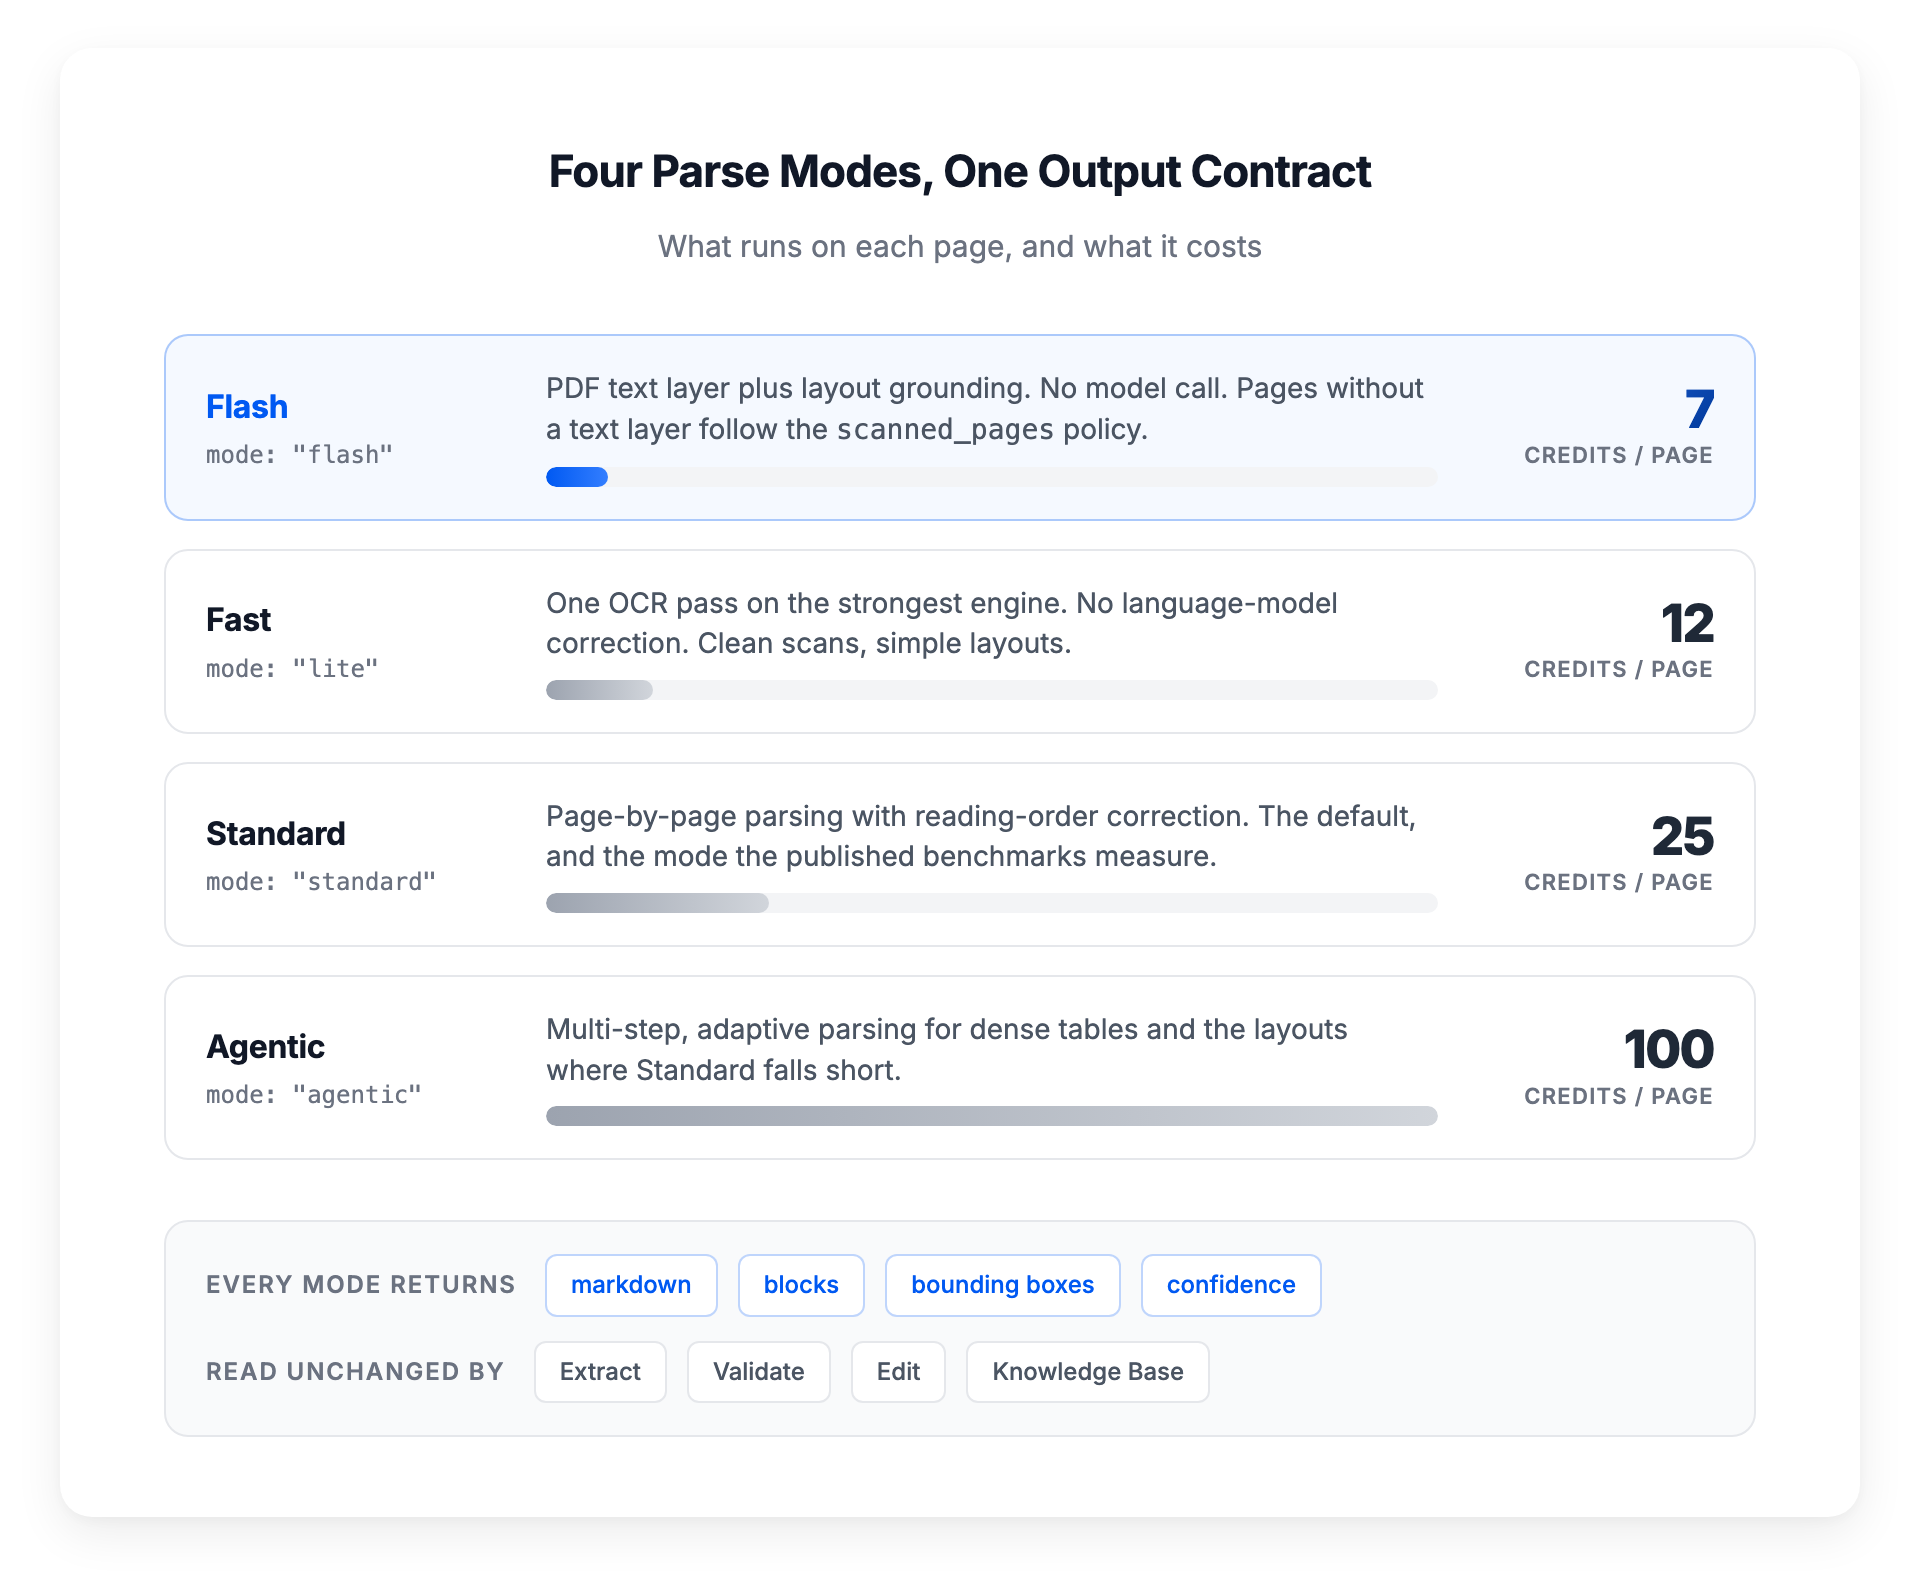
Flash es el peldaño más bajo de una escalera que Parse ahora cubre de punta a punta. Flash, a 7 créditos, lee la capa de texto sin modelo. Fast, a 12, hace una sola pasada de OCR con el motor más potente, sin corrección por modelo de lenguaje, para escaneos limpios con diseños sencillos. Standard, a 25, es el modo por defecto: procesado página a página con corrección del orden de lectura, el modo que miden nuestros benchmarks publicados. Agentic, a 100, es el modo multietapa para tablas densas y los diseños donde Standard se queda corto.
La recomendación de la documentación es conservadora a propósito. Empieza en Standard. Baja un flujo a Fast o Flash para los tipos de documento donde aguanta, y sube a Agentic solo donde Standard rinde peor. «Donde aguanta» no es una corazonada que tengas que aceptar a ciegas: la suite de Evals es la forma de averiguarlo. Construye un dataset de referencia para un tipo de documento una vez, ejecuta el flujo en Flash y lee el resultado campo a campo. Si los números aguantan, el cambio de modo se paga solo en el siguiente lote. Si no, lo has aprendido en el dataset y no en producción.
Dónde compensa
Los casos de uso son los de alto volumen generados por máquina. Facturas de proveedor que llegan en PDF desde los sistemas de facturación de otras empresas. Extractos bancarios y de tarjeta descargados de portales. Contratos, pólizas e informes generados a partir de plantillas. El archivo de diez años de documentos de origen digital que nadie ha procesado porque hacerlo a precio de modelo nunca entró en el presupuesto, y sobre el que una Knowledge Base podría estar respondiendo preguntas la semana que viene.
La cuenta es tan sencilla que se hace de cabeza. Un flujo que procesa 100.000 páginas de origen digital al mes en Standard gasta 2.500.000 créditos en el parseo. En Flash gasta 700.000. El mismo contrato de salida, el mismo flujo después, los mismos resultados de ejecución.
Flash está disponible hoy en la plataforma de anyformat. Pon mode a flash en el nodo Parse, elige la política de scanned_pages, y el resto del flujo se ejecuta como antes. La documentación de Parse cubre los cuatro modos, y la página de créditos tiene el coste de cada uno.
anyformat es la plataforma de inteligencia documental que convierte documentos no estructurados en datos fiables y estructurados, con seguridad de nivel empresarial, puntuaciones de confianza y trazabilidad completa. Más información en anyformat.ai.